
我方AI盒子 · 核心優勢
一次開發、多端適配
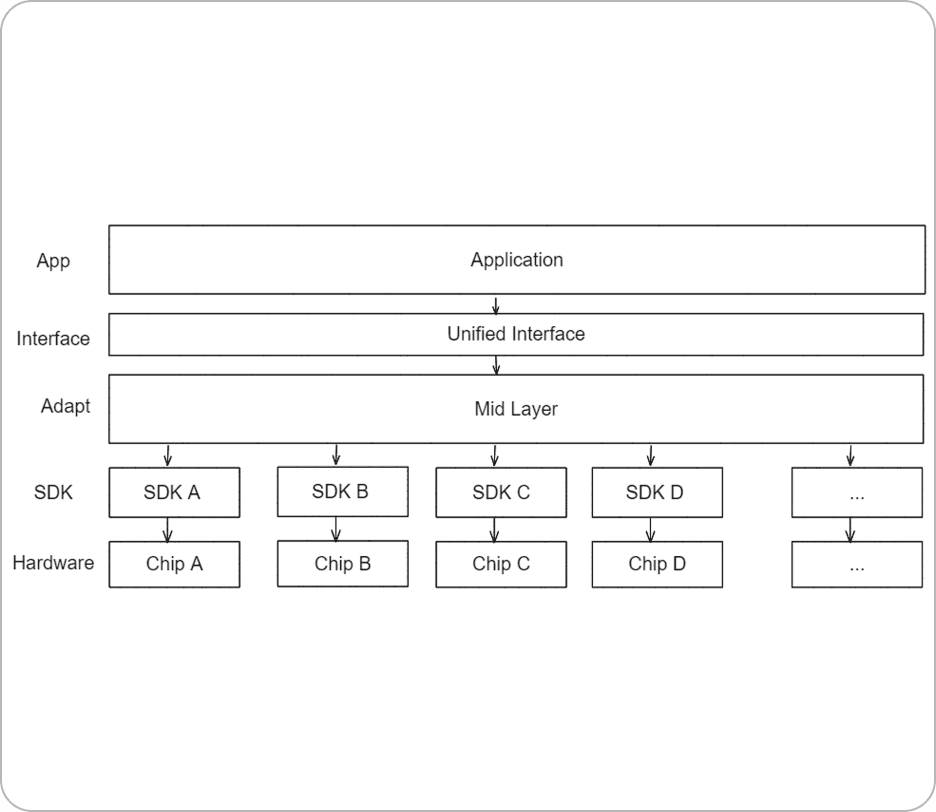
打造統一硬體加速介面,應用只需一次編寫,可自適應不同晶片硬體能力,徹底解決多晶片重複適配問題。
底層極致提速
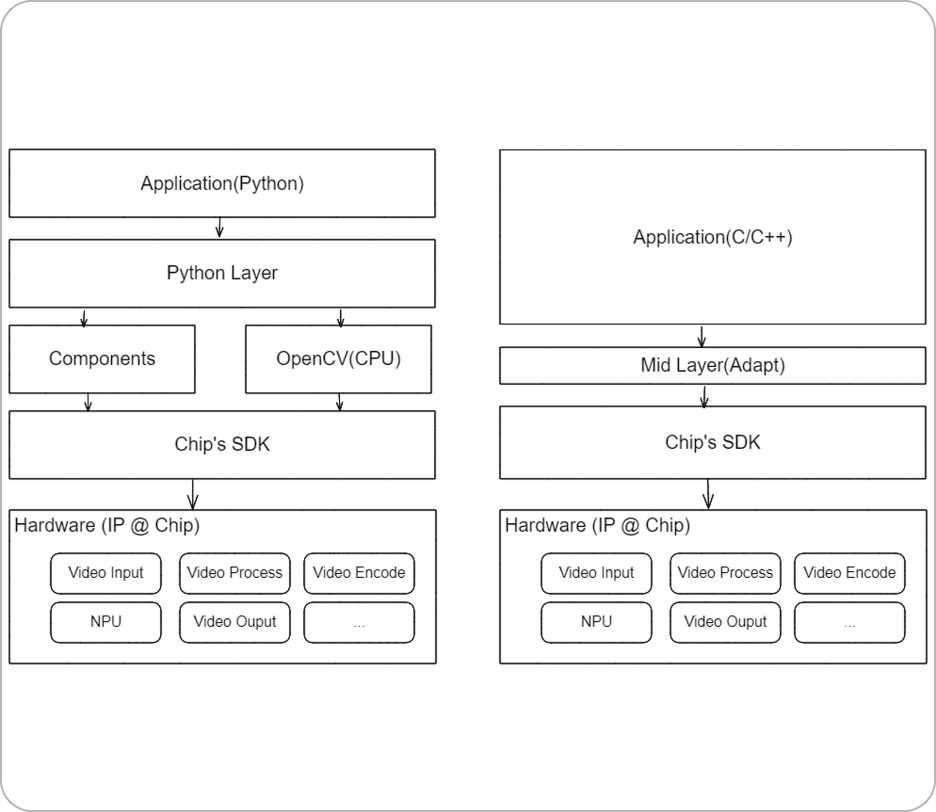
基於晶片原生SDK深度定製,採用C/C++高效語言開發,摒棄低效通用庫與流水線。
全方位深度優化
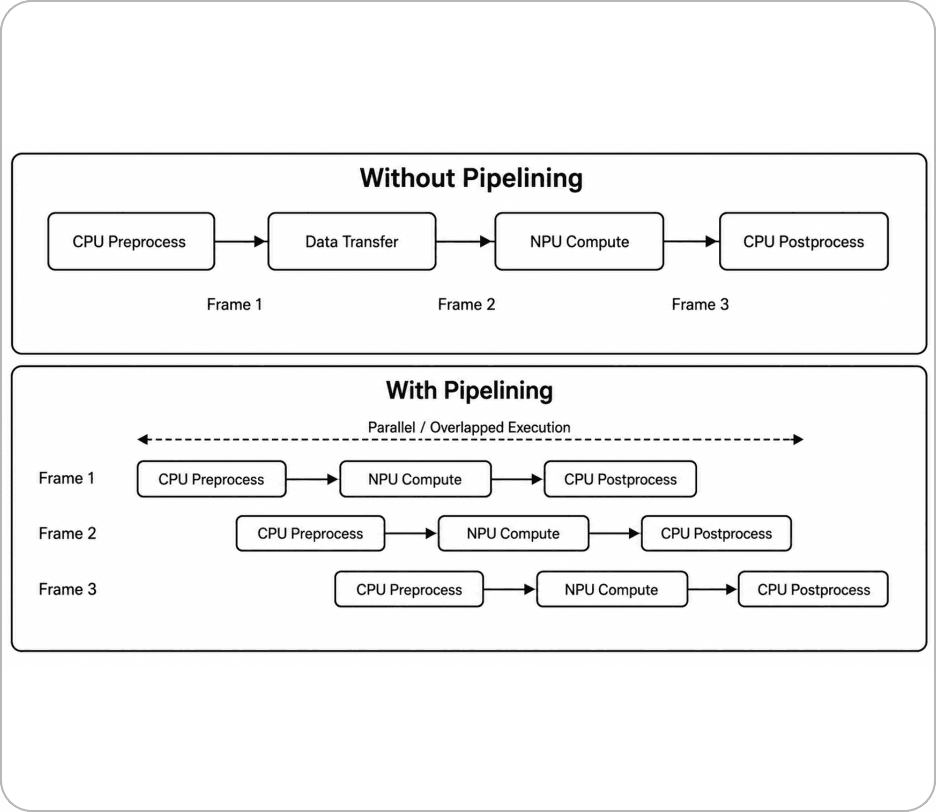
實現算子融合、記憶體複用、指令流水線三重優化,同時重構極致資料流水線,最大化挖掘晶片硬體算力。
零依賴輕量部署
第三方庫零依賴,程式運行加依賴體積<1M,可直接部署到資源受限產品。
抽象統一 · SDK 原生 · 算子融合 · 記憶體複用 · 指令流水 · 自適應量化 —— 六大底層技術支撐
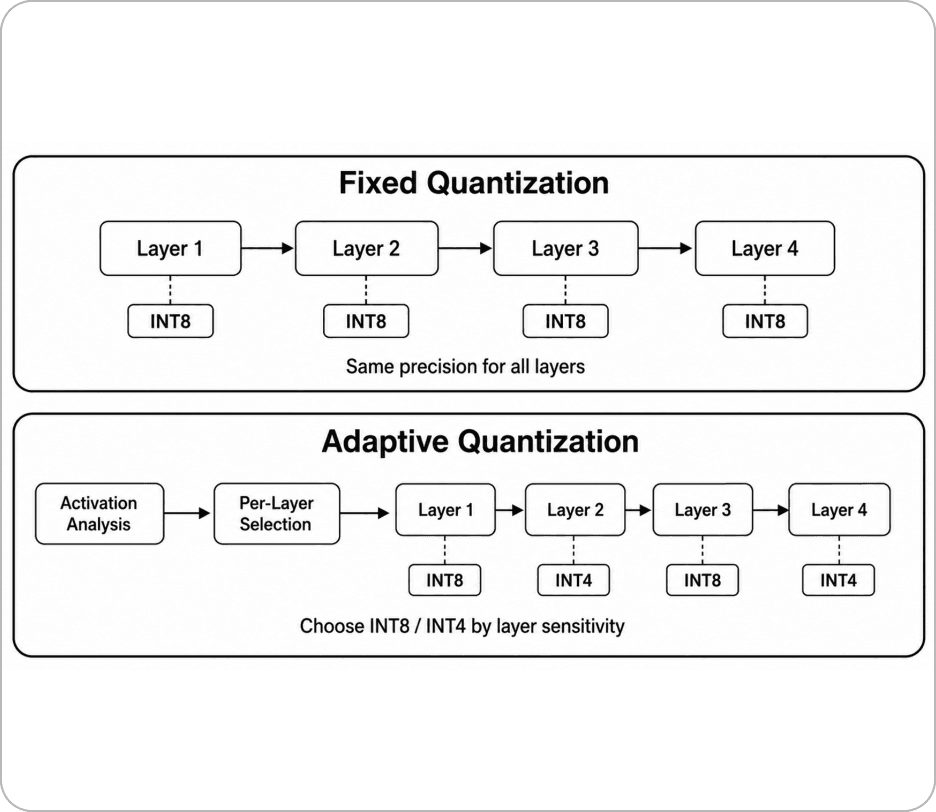
算力、能效、精度、延遲、並發、長穩同步躍遷,同樣硬體支援更大模型、更多路數、更低功耗;抽象統一讓應用一次編寫即可跨多晶片適配;資料、傳輸、運維、可視化、迭代同步提速。
晶片上層調用方式、軟硬體適配、部署接入、資料流水線效率,是AI盒子落地應用的核心基礎能力
打造統一硬體加速介面,應用只需一次編寫,可自適應不同晶片硬體能力,徹底解決多晶片重複適配問題。
基於晶片原生SDK深度定製,採用C/C++高效語言開發,摒棄低效通用庫與流水線。
實現算子融合、記憶體複用、指令流水線三重優化,同時重構極致資料流水線,最大化挖掘晶片硬體算力。
第三方庫零依賴,程式運行加依賴體積<1M,可直接部署到資源受限產品。
無統一硬體介面,每款晶片需要單獨開發適配,多晶片場景複用率極低。
依賴OpenCV等第三方通用庫處理業務,搭配Python高階語言、Ros2低效資料流水線,資源損耗大。
完全使用晶片廠公版SDK,原生預設邏輯運行,不做任何算子、記憶體、指令深度優化。
依賴Python、OpenCV及其它第三方庫,程式運行加依賴體積幾百M~幾G,無法部署到資源受限產品。
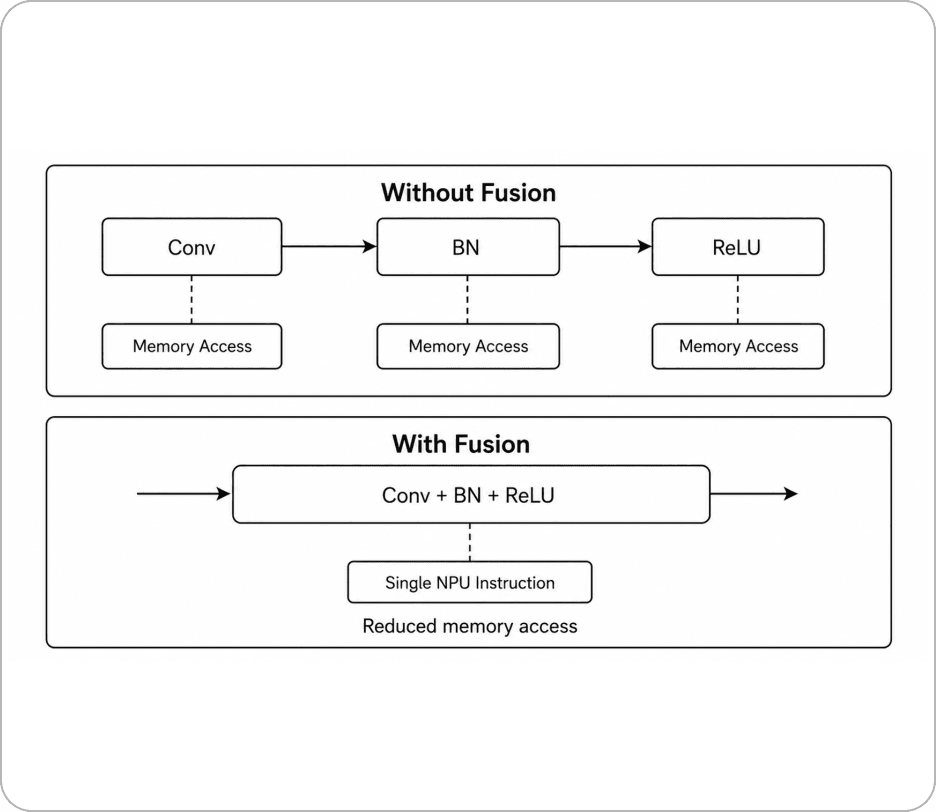
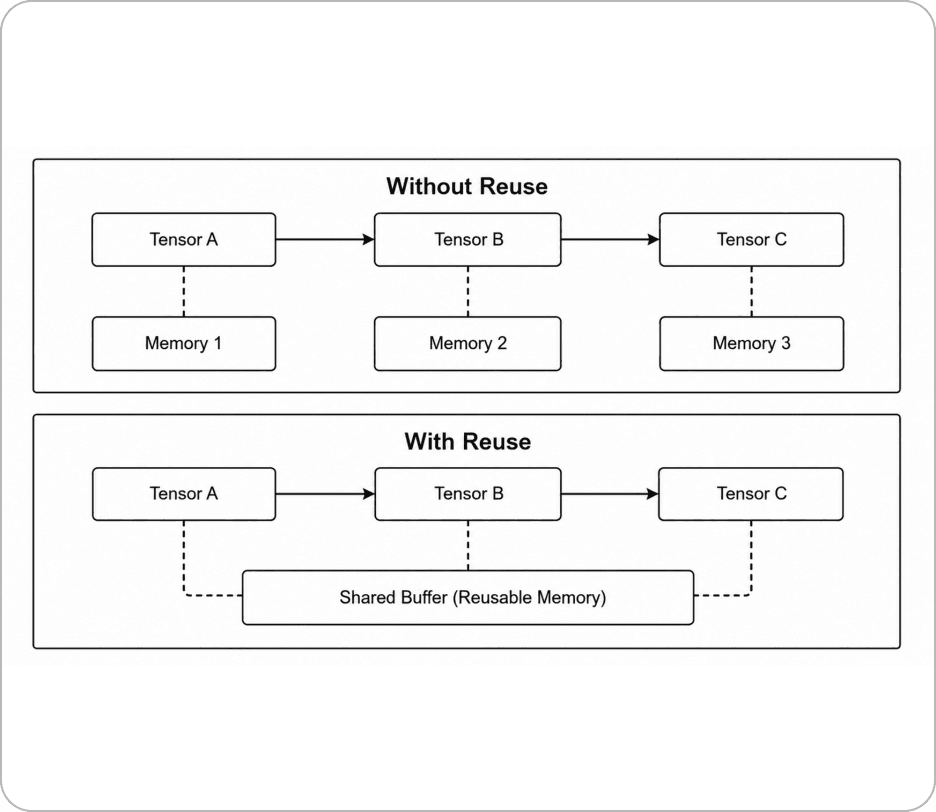
Lite 系列原本只能跑 YOLOv8n,優化後可跑 YOLOv8s(幀率不降)
同樣算力下承載更多視訊通道,提升邊緣側並發處理能力。
面向模型結構與晶片特性做功耗調度,降低長期運行能耗。
優化記憶體、算子與資料流水線,讓單位資源輸出更高推理效率。
統一底層適配能力,覆蓋更多晶片平台與硬體形態。
測試環境
硬體:Pro
模型:YOLOv8n
解析度:1080p


