
我方AI盒子 · 核心优势
一次开发、多端适配
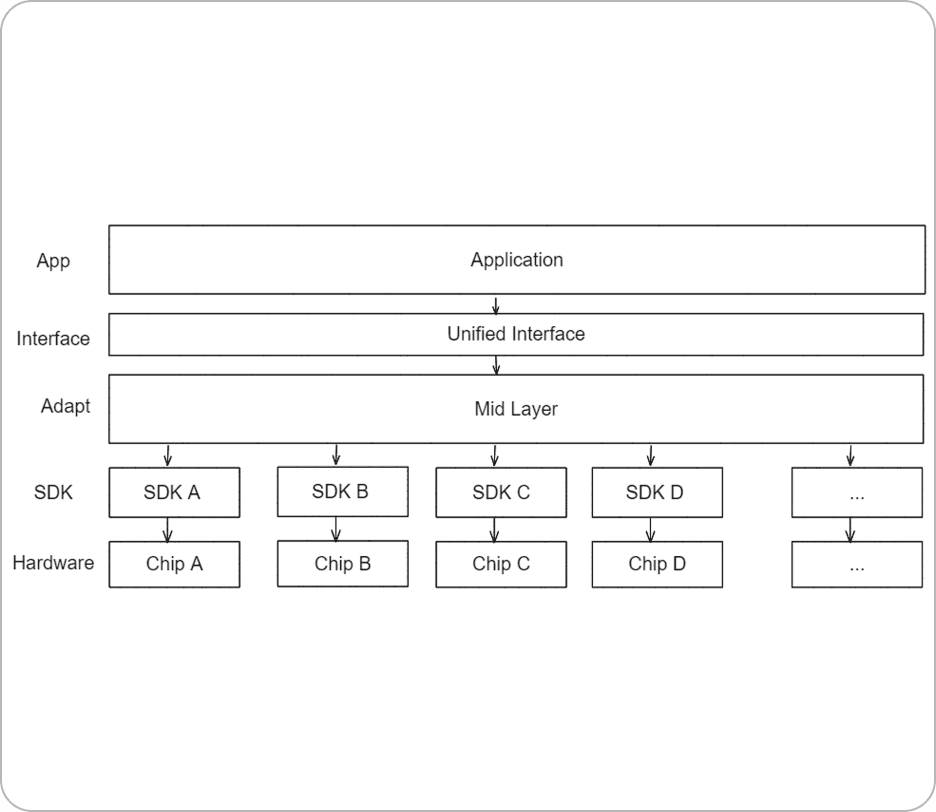
打造统一硬件加速接口,应用只需一次编写,可自适应不同芯片硬件能力,彻底解决多芯片重复适配问题。
底层极致提速
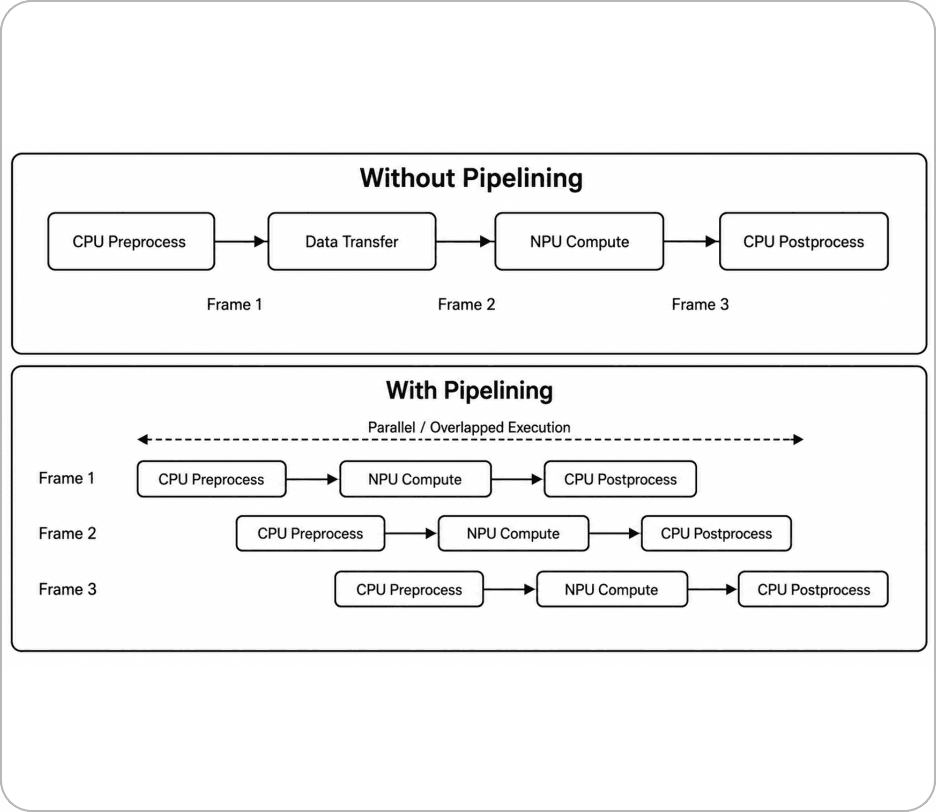
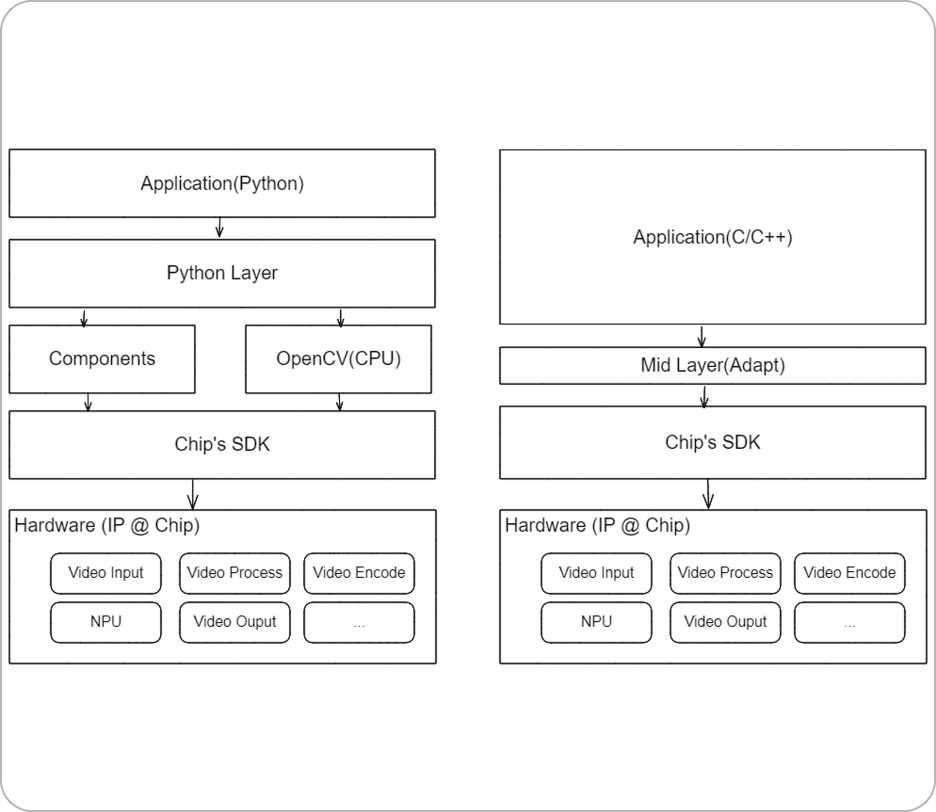
基于芯片原生SDK深度定制,采用C/C++高效语言开发,摒弃低效通用库与流水线。
全方位深度优化
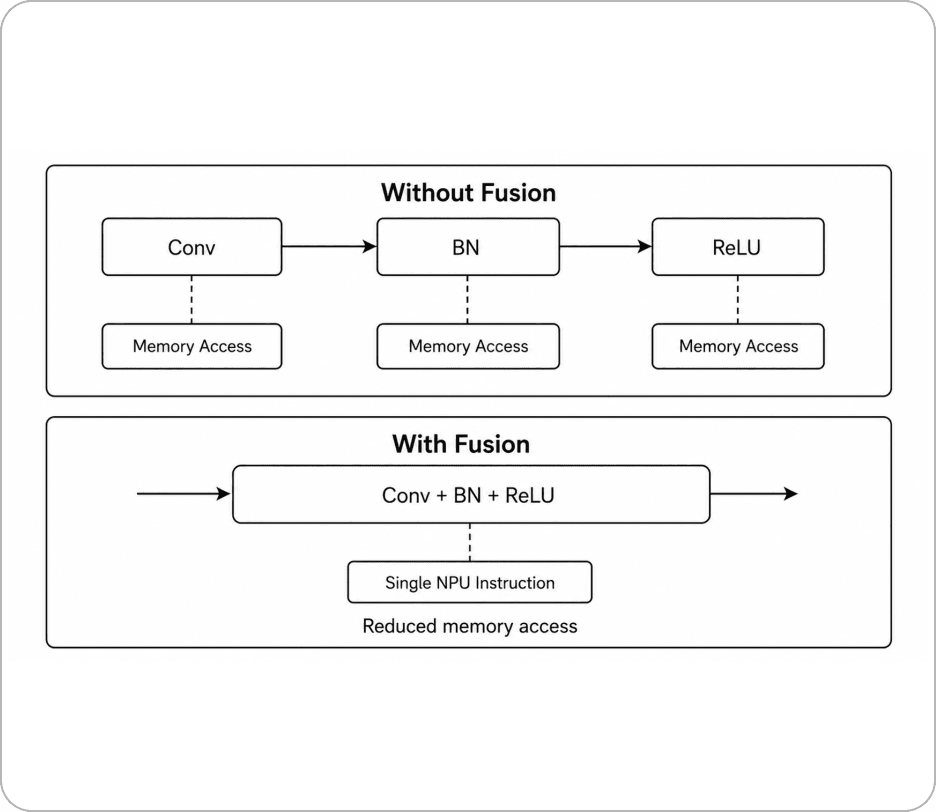
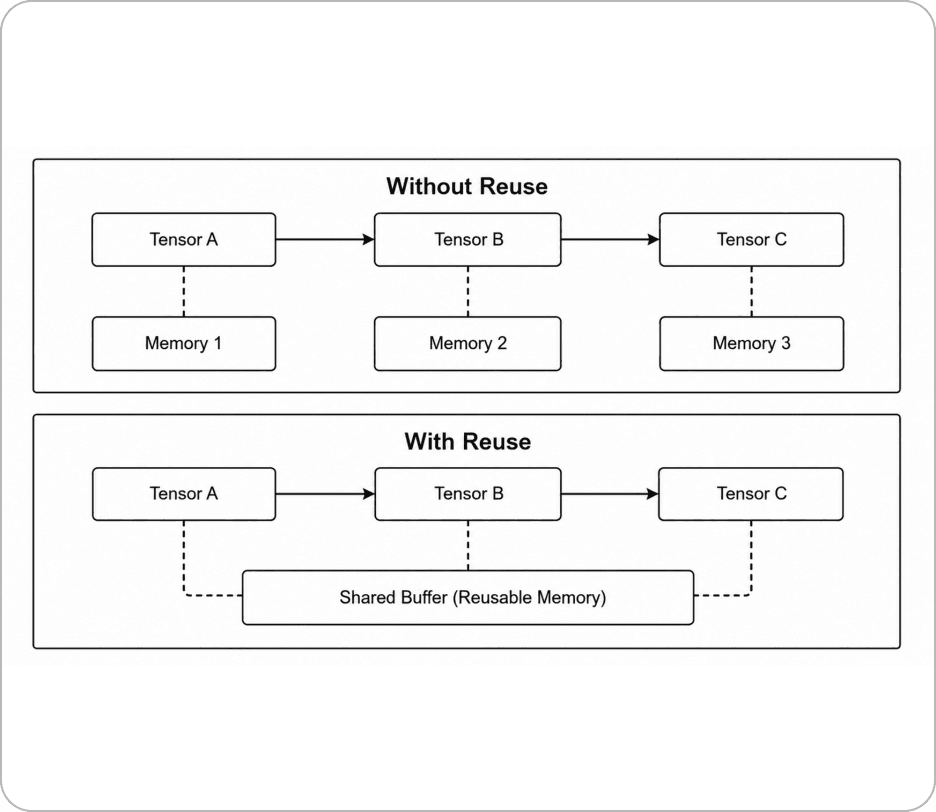
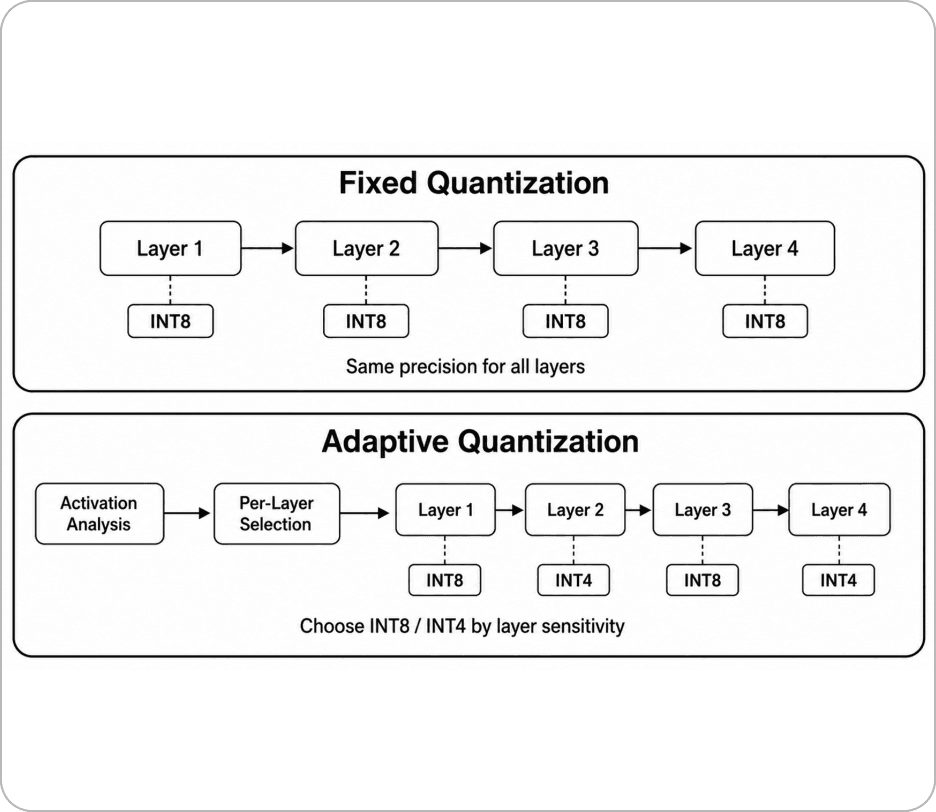
实现算子融合、内存复用、指令流水线三重优化,同时重构极致数据流水线,最大化挖掘芯片硬件算力。
零依赖轻量部署
第三方库零依赖,程序运行加依赖体积<1M,可直接部署到资源受限产品。
抽象统一 · SDK 原生 · 算子融合 · 内存复用 · 指令流水 · 自适应量化 —— 六大底层技术支撑
算力、能效、精度、延时、并发、长稳同步跃迁,同样硬件支持更大模型、更多路数、更低功耗;抽象统一让应用一次编写跨多芯适配;数据、传输、运维、可视化、迭代同步提速。
芯片上层调用方式、软硬件适配、部署接入、数据流水线效率,是AI盒子落地应用的核心基础能力
打造统一硬件加速接口,应用只需一次编写,可自适应不同芯片硬件能力,彻底解决多芯片重复适配问题。
基于芯片原生SDK深度定制,采用C/C++高效语言开发,摒弃低效通用库与流水线。
实现算子融合、内存复用、指令流水线三重优化,同时重构极致数据流水线,最大化挖掘芯片硬件算力。
第三方库零依赖,程序运行加依赖体积<1M,可直接部署到资源受限产品。
无统一硬件接口,每款芯片需要单独开发适配,多芯片场景复用率极低。
依赖OpenCV等第三方通用库处理业务,搭配Python高级语言、Ros2低效数据流水线,资源损耗大。
完全使用芯片厂公版SDK,原生默认逻辑运行,不做任何算子、内存、指令深度优化。
依赖Python、OpenCV及其它第三方库,程序运行加依赖体积几百M~几G,无法部署到资源受限产品。
Lite 系列原本只能跑 YOLOv8n,优化后可跑 YOLOv8s(帧率不降)
同样算力下承载更多视频通道,提升边缘侧并发处理能力。
面向模型结构与芯片特性做功耗调度,降低长期运行能耗。
优化内存、算子与数据流水线,让单位资源输出更高推理效率。
统一底层适配能力,覆盖更多芯片平台与硬件形态。
测试环境
硬件:Pro
模型:YOLOv8n
分辨率:1080p


